语音输入的下半场:说出来的话,怎么变成能直接发出去的文字
语音输入这件事,很早就不缺"识别率"了。你对着手机说一段话,转出来的字基本都对——但你多半不会直接把它发出去。真正卡住的地方是:口语和书面语之间隔着一道工序,而这道工序一直没人替你做。
这是我最近在做的一个小工具想解决的问题。它不是又一个输入法,而是给"说出来的话"补上后半段处理:说完之后,按当前场景整理成能直接发出去的书面文字,再落到光标位置。整条链路分三段。
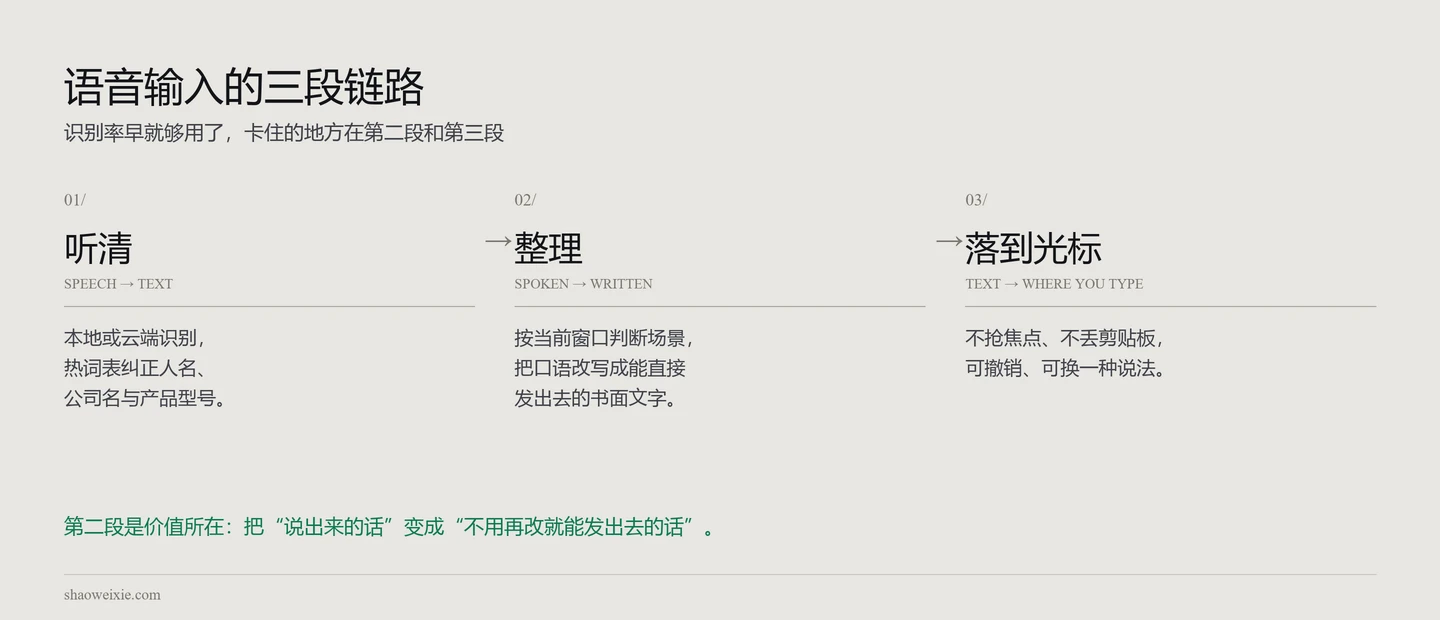
图 1 · 第一段负责听清,第二段负责成文,第三段负责把文字放到对的地方
第一段:听清,但不止是听清
识别引擎有两个,可以互相兜底:云端实时识别和本地模型。云端的好处是边说边出字——不是等你说完才开始转,而是按下按键就建立连接,说一句出一句;本地引擎则在云端不可用时接手,代价是慢一些、但离线可用。整理用的语言模型同样是双份:在线的一个不通就自动回落本地,输入过程不会因此中断。
这一段里真正值得说的是热词表。
识别模型对通用词汇很准,但对三类词几乎必然会错:人名、公司名、产品型号。这些词既不在通用语料里高频出现,又恰恰是错了后果最严重的部分——把客户名字认错,整封邮件就废了。
所以热词表被外置成一个纯文本文件,一行一个词,改完保存立即生效(程序按文件修改时间判断是否重载),不用重启。写指令时:
- 识别阶段把这些词作为偏置提示送进引擎,提高命中率;
- 整理阶段把它们作为"专有名词以此为准"的清单交给模型,用来纠正同音错字。
同一份清单,两处生效。这是这个工具里我最满意的一个设计——把"机器不擅长的确定性"交还给用户维护,而不是试图让模型猜。
输入模式也有两种,对应不同场景:短句用"说完再整理",长文用"边说边逐句输入"(实时模式下识别引擎的断句阈值会收紧到 0.5 秒,说完一句立刻落字)。按住另一个修饰键则进入"只转文字"模式,跳过整理——需要一字不差记录原话时用。
第二段:整理,也是这套东西的价值所在
整理不是"润色一下",而是按场景换一套写法。同一句口语,在聊天窗口、邮件正文、正式文档和 AI 提示框里,应该是四种不同的文字。
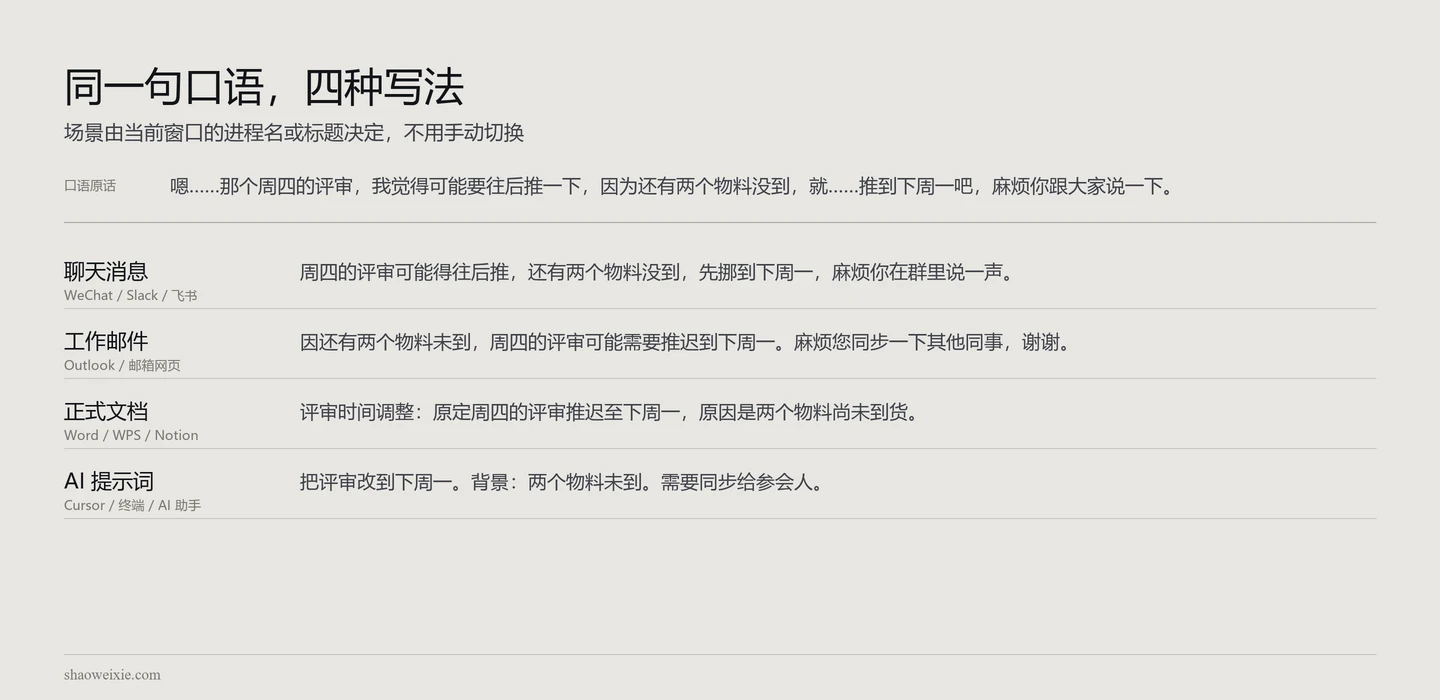
图 2 · 场景由当前窗口决定,不需要手动切换
场景判断很朴素:取前台窗口的进程名,进程名不够用时看窗口标题(浏览器里的网页版邮箱就是这样识别出来的)。当前覆盖聊天消息、工作邮件、正式文档、AI 提示词四类,加一个通用兜底。整理强度也分三档:轻度只去口头禅和改口,标准重组成通顺的书面语,深度则按逻辑重排、先说结论再说细节。
但这一段真正决定成败的,不是文采,是边界。
输入法是一个很特殊的软件:它的输出直接进入别人的聊天窗口和邮件正文,你对它几乎没有复核的时间。如果它自作主张补了一句"我们会尽快处理",或者把"可能推迟"写成"确定推迟",这不是文笔问题,是一次事故。
所以提示词里花最大篇幅写的不是"要写成什么样",而是"不许做什么"。
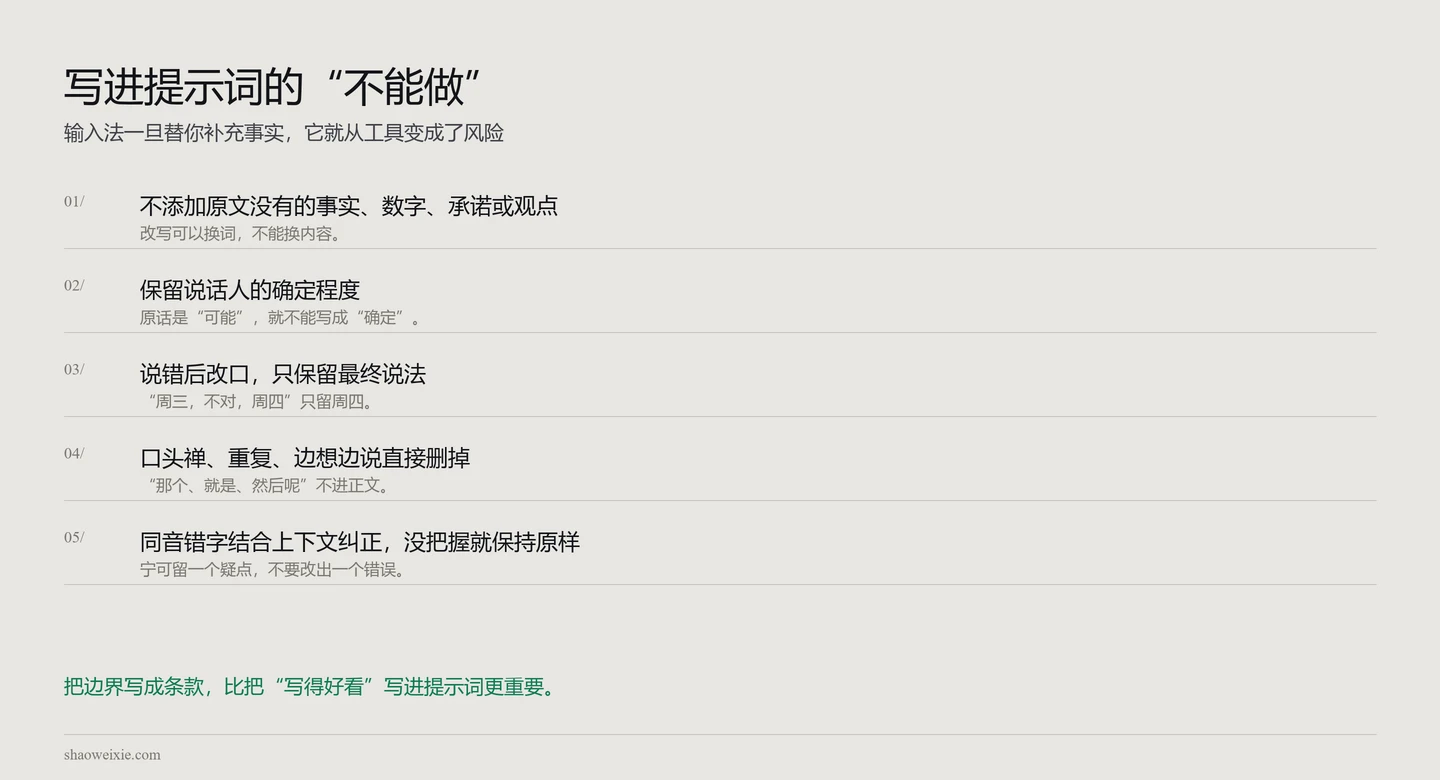
图 3 · 五条底线,比"写得好看"重要得多
具体是这几条:
- 不添加原文没有的事实、数字、承诺或观点。 改写可以换词,不能换内容。
- 保留说话人的确定程度。 原话是"好像、可能、大概",输出就必须还是推测语气。这一条我认为是整套规则里最容易被模型破坏、后果又最严重的一条。
- 说错后改口,只保留最终说法。 口语里"周三,不对,周四"这种自我修正,只留周四。
- 口头禅、重复、边想边说直接删掉。 “那个、就是、然后呢、怎么说呢"不进正文——这也是语音输入最需要的一步,人说话时约有两三成是填充词。
- 同音错字结合上下文纠正,没把握就保持原样。 宁可留一个疑点,也不要改出一个错误。
规则之外还配了示例(同一句口语的轻度/标准/深度三版),因为对模型来说,一个例子比三条规则管用。
第三段:落到光标处,最容易被忽略
前两段做完,你只是拿到了一段好文字。能不能"用起来”,取决于第三段——而这一段几乎全是细节问题,每一个都足以让工具不可用:
提示条不能抢焦点。 录音时要在屏幕上显示状态(正在听 / 整理中 / 完成),但如果这个提示窗口抢走了焦点,你正在打字的窗口就失去焦点了,紧接着的粘贴会落到错误的地方。解决办法是给窗口加上不激活的扩展样式,并用不激活显示的方式调出来——窗口显示、置顶,但绝不成为活动窗口。
粘贴要等你松开按键。 快捷键是按住说话,如果手指还没松开就发送粘贴组合键,两个键会打架。所以粘贴前先循环等待,直到检测到说话键和指令键都松开。
剪贴板要备份并还原。 粘贴靠剪贴板,就意味着要临时占用它。开始录音前记下原内容,输入完成后还回去——否则你复制到一半的东西就没了。
不满意要能重来。 整理了但不像自己想说的话,是很常见的事。这时按一个键"换个说法":程序撤销上一次粘贴,用不同措辞重新生成一版,再粘贴回去;不满意可以连续按,每次都换一种句式、并且不允许与上一版雷同。
选中的文字可以当上下文。 选中一段文字后按住指令键说"改成更正式的语气",处理结果会直接替换选中内容。这实际上把"语音输入"扩展成了一个语音驱动的文本编辑:改写、翻译、缩写、总结,都是同一套交互。
还有一个很小的决定:托盘图标按状态变色(听 / 整理 / 完成 / 出错)。不需要看提示条,余光扫一下托盘就知道现在是什么状态。
几个工程上的小选择
- 密钥不进代码库。 所有 API 密钥存在 Windows 凭据管理器里(按当前 Windows 账户加密),程序里不留明文;如果检测到早期版本留下的明文密钥文件,会自动转存并清空删除。
- 历史只存本地。 每条输入记录写入本机一个 jsonl 文件(含场景、音频时长、识别文本与整理结果),便于回看和统计当日条数/字数/时长。不需要就关掉。
- 单实例锁。 用一个本地端口做互斥,重复启动会提示"已经在运行",而不是起出两个抢麦克风。
- 保护性上限。 单次录音最长 5 分钟;录音短于 0.4 秒或音量近零直接判为"没听到声音",不进识别。
写在后面
做这个工具的过程里,我越来越觉得:这类小工具的成败在边界,不在能力。
模型能力是现成的——识别、改写、翻译,都有成熟的 API 可用。真正需要设计的是另外三件事:
- 把不确定的地方收敛成条款。 模型能做什么不用写,它自然会做;不能做什么必须逐条写死,因为越界的代价由你承担。
- 把最贵的延迟藏起来。 从松手到出字只有一两秒,用户能忍受;但如果这一两秒里没有反馈,就会被判定为"卡住了"。所以提示条要在每一步都给出状态。
- 把主动权留给用户。 能撤销、能重说、能跳过整理、能关掉历史。工具越靠近真实的表达现场,就越不能替人做决定。
如果你也在用语音输入,不妨想一下:你上一次没有把转出来的字直接发出去,是因为哪里不对?