语音输入工具的下一步:哪里该交给硬件,哪里该换成 Rust
上一篇把语音输入拆成三段链路:听清、整理、落到光标。那篇讲的是"怎么做"——识别用双引擎兜底、热词表交给用户维护、整理这一步用提示词把边界写死。
这篇讲"接下来往哪走"。有两个问题一直悬着:软件的尽头在哪里(哪些该交给硬件),以及要不要换掉实现语言(准备用 Rust 重写)。两件事的答案都落在同一个动作上——先分清责任,再决定写什么代码。
一、先分清责任:识别错误有两个来源
把识别错误分成两类,很多纠结就自动消失了。
一类是声学的:环境噪声、离麦克风太远、口音、麦克风本身的素质。这类错误的信息在采集那一刻就已经丢了——后面无论用什么模型,都是在猜。
一类是语言的:专有名词、同音词、断句。这类错误跟音质无关,靠词表、上下文和常识就能纠正。
想清楚这一点,边界就出来了:软件能提高"用对的词",不能提高"听到的音质"。 语言侧的办法(热词表、场景改写、同音纠错)基本都被榨干了;声学侧软件只能做前处理——降噪、自动增益、静音检测,这些能把信号"整理"干净一点,但补不回已经丢失的信息。
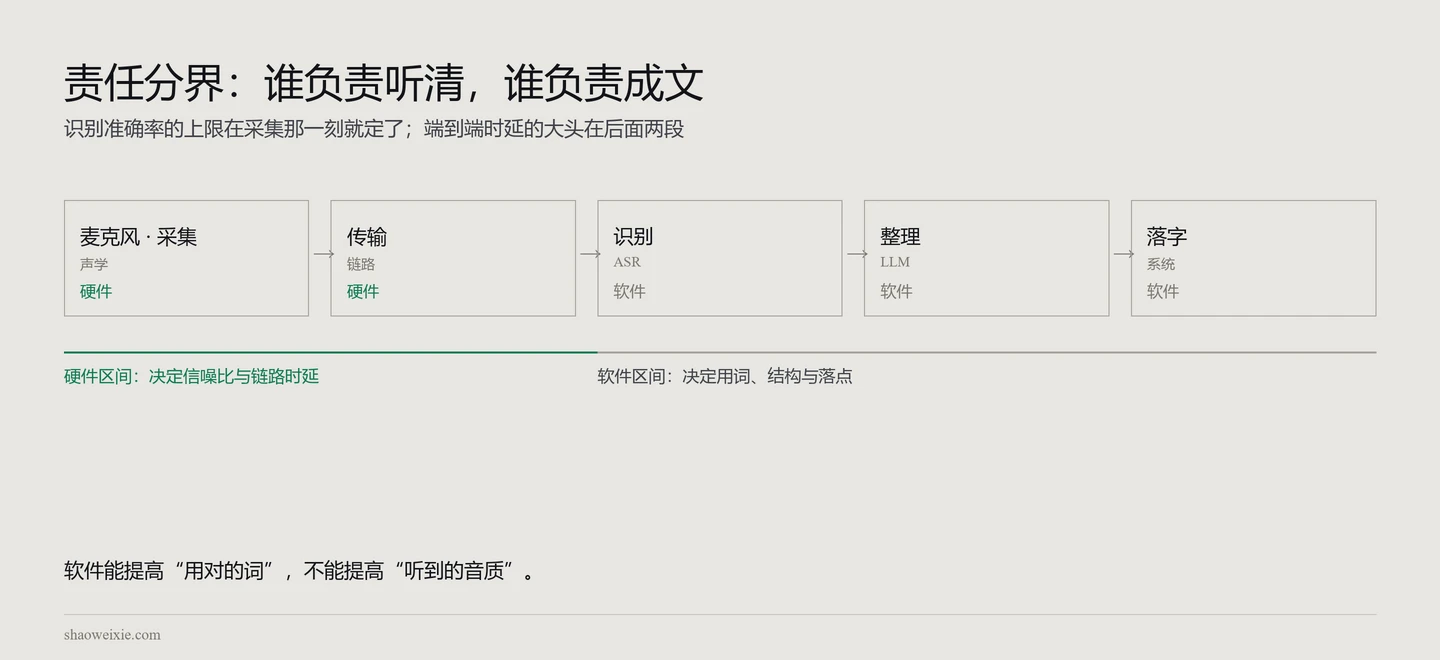
图 1 · 前两段由声学与链路决定,后三段才是软件的主场
二、硬件能补的,是采集这一段
按收益排序,硬件能改善的有四件事:
第一是麦克风与阵列。 离嘴更近、指向性拾音、波束成形,这些都直接提高信噪比。而识别准确率的上限,本质上就是信噪比决定的——这是软件无法替代的一环。同一套识别模型,换个拾音条件,错误率可以差出数倍。
第二是给"按住说话"一个真正的物理按键。 现在用的是键盘快捷键,本质是妥协:手要离开主键区、误触无法避免、“到底按下去了没有"只能靠屏幕上的提示条确认。物理按键能给出触觉反馈——这类反馈的价值在长期使用中才显现出来,它决定了你会不会一直用它。
第三是端侧唤醒与端侧识别。 好处有两个:音频不出设备(隐私),以及不依赖网络往返(延迟)。对经常在会议、通勤场景用语音输入的人来说,这两点都比"识别率高一个百分点"更有意义。
第四是链路时延。 如果设备与主机之间走无线,编码和缓冲会引入几十到几百毫秒。对"松开手就出字"这种体验来说,这段时间是硬成本,而且它和识别、整理的时间是相加的,不是并行的。
三、硬件改善不了的三件事
但硬件不是万能药。有三件事它帮不上,而且恰恰是上限所在:
“整理"这一步动不了。 把口语改写成能直接发出去的书面文字,需要语言模型,还需要场景上下文——当前是哪个应用、哪个窗口、有没有选中的文字。这些信息在 PC 上最全、最实时。设备想独立完成"整理”,等于要在设备上跑一个语言模型,还要猜你正在用哪个软件。
确定性的问题解决不了。 人名、公司名、产品型号该怎么写,是一个"事实问题”,只能靠用户维护的清单(热词表)解决,跟算力和硬件无关。
串行耗时的大头不在采集。 端到端时延通常是"识别耗时 + 整理耗时 + 网络往返"的相加,而后者往往占大头。所以真要优化延迟,第一步不是买硬件,是先把各段耗时量出来。
结论是分工,不是替代:设备负责听清,PC 负责成文。 如果真要在硬件上动手,顺序应该是先补"听不到的损失"(采集),再压"看得见的延迟"(识别与整理的串行时间)。
四、为什么准备用 Rust 重写
另一半的纠结在实现语言上。现在的版本是 Python 写的,能跑、功能也全,但有几处痛点越来越明显。
第一是分发与常驻。 这是个开机就要待在托盘里的程序,理论上应该是一个几十兆的单文件,双击就能用。而 Python 方案要带运行时和一堆二进制依赖,体积、启动时间、以及目标机器上缺某个 DLL,都会变成用户侧的问题——而这类工具的用户体验,很大一部分就毁在"装不上"和"起不来"上。
第二是时序,这才是真正的复杂度。 这个程序的难点从来不是功能,是时序:录音线程、识别回调、整理请求、UI 线程、按键松开检测、粘贴的时机。用字典加锁能跑起来,但类型系统帮不上忙——状态只存在于作者的记忆里。这类程序最容易踩的坑,几乎都是同一类:
- 粘贴时用户还没松开快捷键,两个键打架;
- 剪贴板被临时占用,用户复制到一半的东西丢了;
- 重复启动,两个实例抢麦克风;
- 提示条抢走焦点,粘贴落到错误的窗口。
这些都不是"逻辑写错了",而是状态没有被表达出来。用 Rust 写,可以把"正在录音 / 正在识别 / 正在整理 / 已完成"变成一个真正的枚举状态机,让编译器帮你拦住非法状态——这是我最看重的一点,比性能重要。
第三是系统边缘的调用。 窗口扩展样式位、前台窗口追踪、剪贴板、全局热键,这类调用用 Rust 的 Win32 绑定比 ctypes 更容易写对。
五、会丢掉什么
只讲好处是不诚实的。换语言会丢掉两样东西:
模型生态在 Python 侧最完整。 本地识别、音频前处理、试新模型,Python 是默认入口,轮子最多、文档最全。Rust 侧要么走 C 绑定(比如 sherpa-onnx 这类推理库),要么把模型相关的能力留在独立进程里。
原型速度。 改提示词、换模型、调参数,Python 改一行就能跑;编译型语言的反馈回路要长得多。
所以"全部重写"是错的判断。
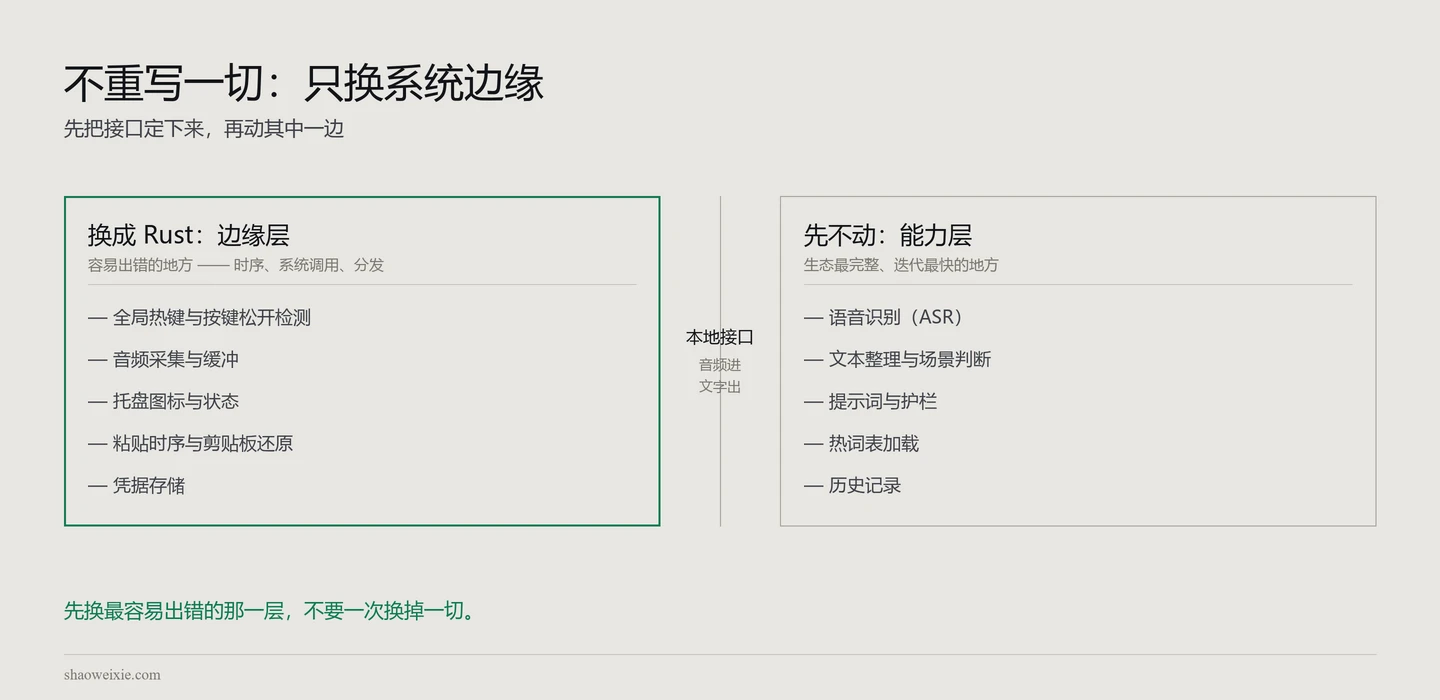
图 2 · 只把最容易出错的一层换掉,模型与提示词先不动
六、打算怎么分层
边缘层换成 Rust:全局热键、音频采集与缓冲、托盘与状态、粘贴时序、剪贴板还原、凭据存储。这一层的特征是——时序敏感、直接调用系统、且必须可靠地随程序分发。
能力层先不动:语音识别、文本整理、场景判断、提示词与热词表,继续留在原来的进程里,通过一个本地接口调用(一段音频进,一段文字出,外加一个状态回执)。
协议先行:先把两层的接口和状态定义清楚,再动其中一边。接口定下来之后,两边可以分别替换、分别测试,不会互相拖住。
一个原则:先换最容易出错的那一层,不要一次换掉一切。
七、顺手核对许可证
这一点值得单独写,因为这是要分发的软件,不是内部脚本。分发前必须确认选用的库允许随程序发布——尤其是不能把 GPL / AGPL 类库链接进来,那会要求整个程序跟着开源。
我核对了这次会用到的主要几个:
| 用途 | 库 | 许可证 |
|---|---|---|
| 音频采集 | cpal | Apache-2.0 |
| Win32 绑定 | windows-rs | MIT OR Apache-2.0 |
| 托盘图标 | tray-icon | MIT OR Apache-2.0 |
| 凭据存储 | keyring | MIT OR Apache-2.0 |
| 本地识别推理 | sherpa-onnx | Apache-2.0 |
都是宽松许可,没有传染性,可以随商业软件分发。这一步花不了十分钟,但漏掉的代价是发布之后才发现要重写某个模块。
写在后面
这两件事看起来一个偏硬件、一个偏软件,其实是同一个动作:先把责任分清,再决定写什么代码。
硬件负责听清,软件负责成文,语言负责把状态表达清楚。工具变复杂的时候,划边界比写代码更有用——因为边界划错了,写多少代码都是在错误的地方使劲。