Windows 10 / 11 · 自用版本 · 持续迭代
声墨 · VoxInk
按住一个键说话,松开后光标处出现的不是识别原文,而是可以直接发出去的书面文字。听清、整理、落字三段都由程序完成,你只需要说。
- 1.6 秒松开手到文字出现(中位)
- 19 次本机实测口述记录
- 0 次记录内的失败
- 5 类自动识别的写作场景
想法:语音输入缺的不是识别率
你对着手机说一段话,转出来的字基本都对——但你多半不会直接把它发出去。真正卡住的是口语和书面语之间那道工序:填充词要去掉、语序要重排、语气要换成合适的分寸、专有名词还得写对。
这个工具就是补上这道工序的。它把语音输入拆成三段,每段只做一件事:
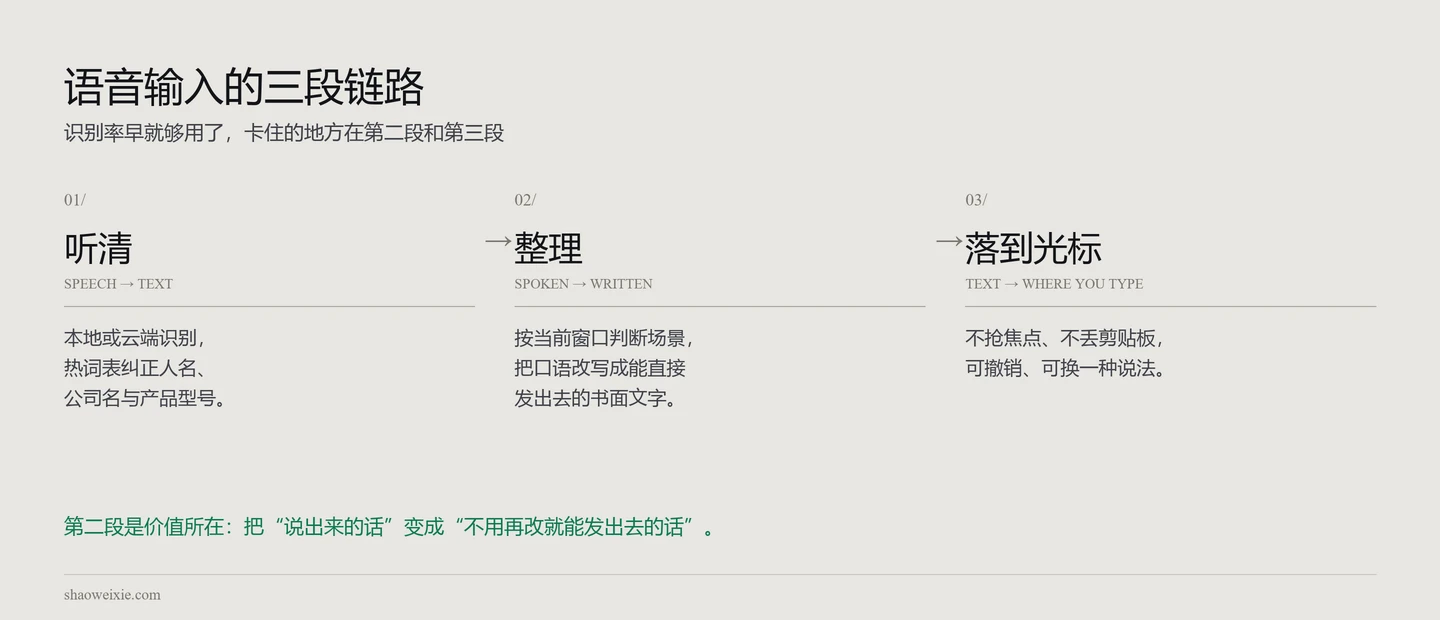
第一段听清,第二段成文,第三段把文字放到对的地方
已经实现的功能
一、听清
- 云端实时识别:按下按键就建立连接,边说边出字;实时模式下停顿 0.5 秒即断句,说完一句立刻落字,不用等整段结束。
- 本地识别兜底:云端不可用时自动切到本地模型,离线也能用;两个引擎在托盘菜单里可随时手动切换。
- 热词表外置成文本文件:一行一个词,专治人名、公司名、产品型号这类"识别永远会错"的词。改完保存立即生效,不用重启;同一份清单在识别阶段作为偏置提示、在整理阶段作为专有名词基准。
- 只转文字:按住说话时同时按一个修饰键,跳过整理,忠实记录原话——需要一字不差时用。
二、整理
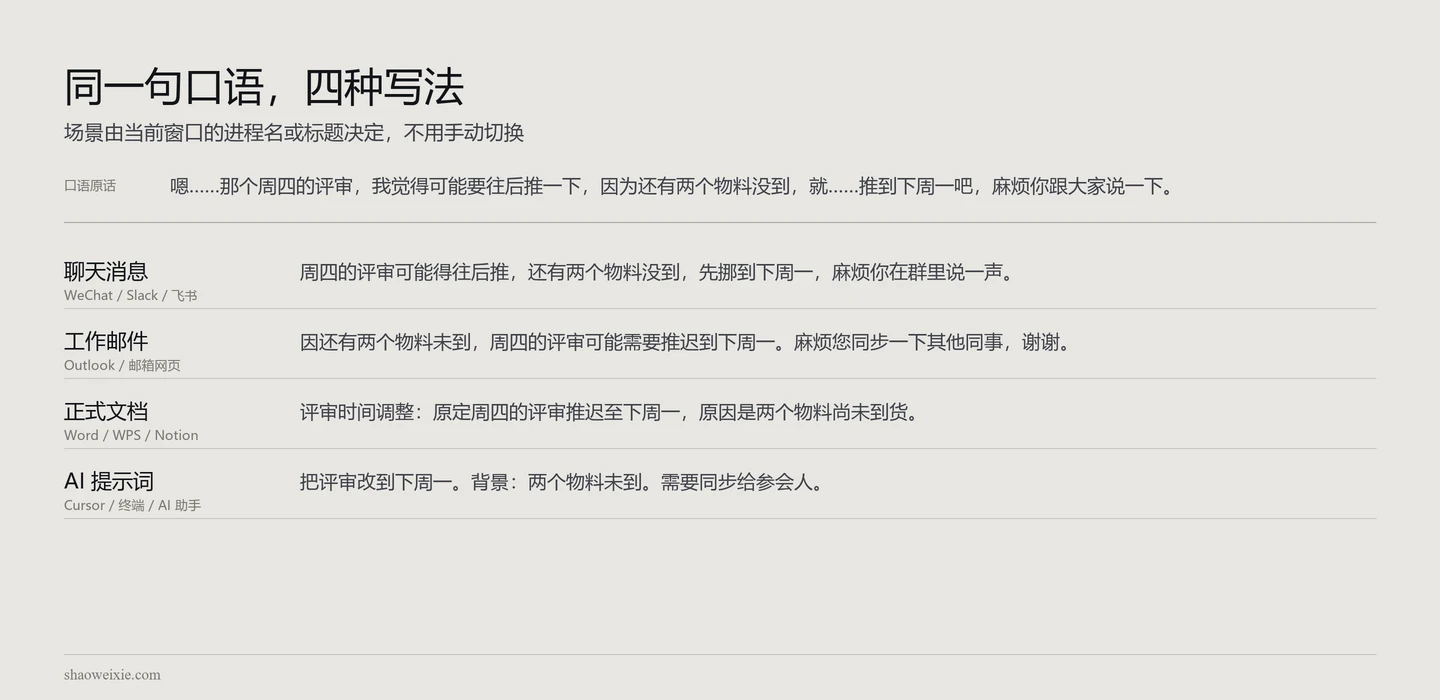
按窗口自动判断场景:取前台窗口的进程名,必要时看窗口标题(网页版邮箱就是这样识别的)。覆盖聊天消息、工作邮件、正式文档、AI 提示词五类,加一个通用兜底,不需要手动切换。
同一句口语,四种写法:
三档润色强度:轻度只去口头禅与改口、保留原话用词;标准重组成通顺的书面语;深度按逻辑重排,先说结论再说细节。
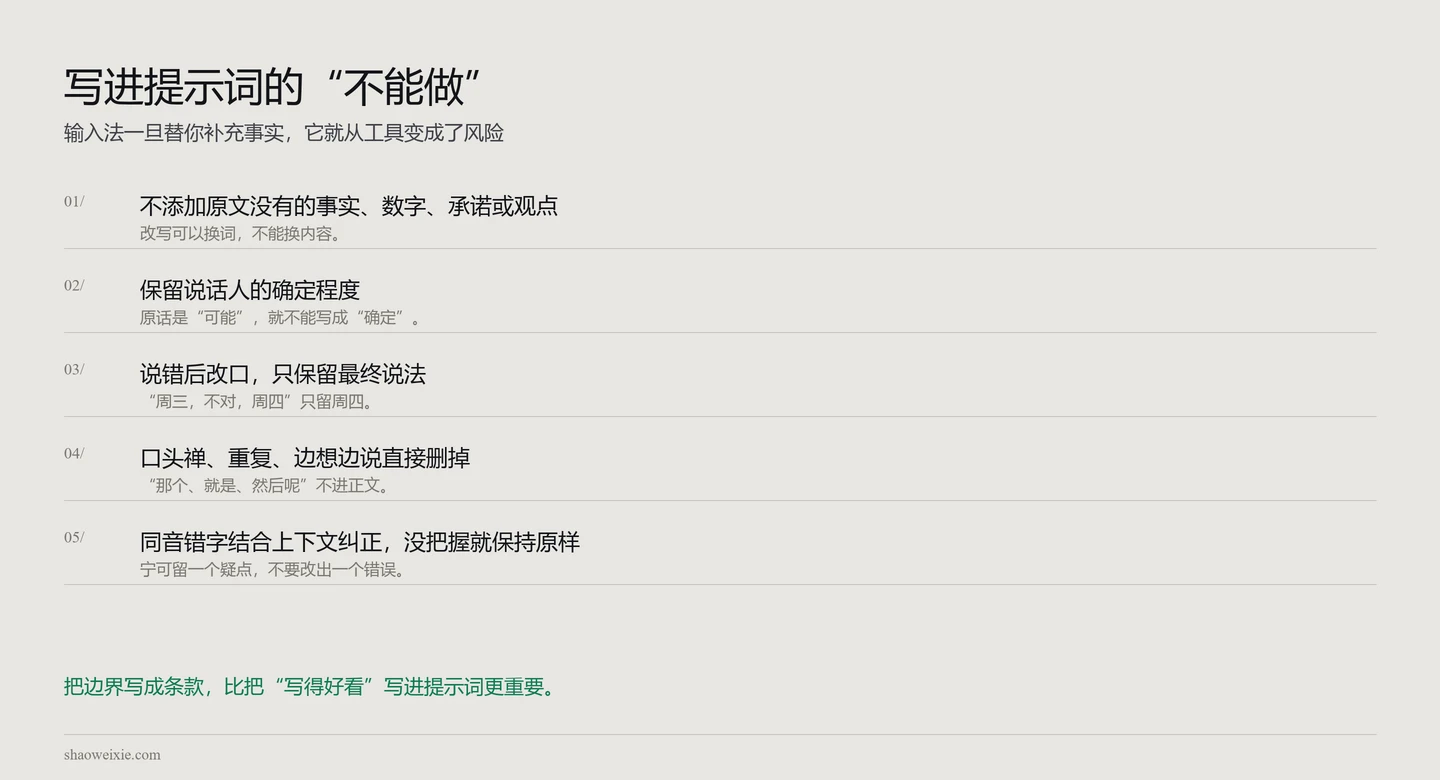
五条写死的护栏:不添加原文没有的事实、数字与承诺;保留说话人的确定程度(“可能"不能写成"确定”);说错改口只留最终说法;口头禅与重复直接删掉;同音错字结合上下文纠正,没把握就保持原样。
边说边翻译:输出语言可切中文 / English / 日本語,说中文直接输出译文,专有名词保持原样。
六、语言与方言
识别引擎按多语种与方言设计,开口前不需要先选模式:
| 范围 | 支持 |
|---|---|
| 中文 | 普通话 |
| 中文方言 | 7 种:吴语、粤语、闽语、客家话、赣语、湘语、晋语 |
| 地域口音 | 26 种:河南、陕西、湖北、四川、重庆、云南、贵州、广东、广西、河北、天津、山东、安徽、南京、江苏、杭州、甘肃、宁夏等 |
| 外语 | 英语、日语;支持语种自由切换与混合识别 |
| 中英混说 | 一句话里中英夹杂(如「这个 assert 要加 timeout」)不用切换模式 |
| 输出语言 | 说中文可直接输出 English / 日本語 译文,专有名词保持原样 |
能力来自识别引擎本身:本地为 Fun-ASR-Nano(中文含 7 方言与 26 口音、英文、日文),云端为实时识别引擎;两者在托盘菜单里可随时切换。
三、落到光标
这一层全是细节,但每一处都决定"能不能天天用":
- 提示条不抢焦点:状态提示显示、置顶,但绝不成为活动窗口——否则你正在打字的窗口会失去焦点,粘贴就落到错误的地方。
- 粘贴前等按键松开:按住说话的键还没松,程序不会抢先发送粘贴组合键。
- 剪贴板备份并还原:粘贴临时占用剪贴板,输入完成后还回原内容,不丢你复制到一半的东西。
- F8 换个说法:整理得不合心意时按一下,程序撤销上一版、用不同措辞重新生成再粘贴;可以连续按,每次句式都不一样。
- 选中文字 + 语音指令:选中一段文字后按住指令键说"改成更正式的语气",结果直接替换选中内容——改写、翻译、缩写、总结都是同一套交互,等于一个语音驱动的文本编辑。
- 单实例运行:用本地端口做互斥,重复启动会提示"已经在运行",不会起两个实例抢麦克风。
四、快捷键
| 按键 | 作用 |
|---|---|
| 按住右 Ctrl | 按住说话,松开结束 |
| 短按右 Ctrl | 切换成"再按一下结束"的开关模式 |
| 右 Ctrl + 右 Shift | 只转文字,不整理 |
| 右 Alt | 语音指令(先选中文字则处理选中内容) |
| F8 | 对刚输入的内容换个说法 |
| Esc | 取消本次录音 |
声纹闸门(硬件方向)
三段链路之外再加一道闸门:只有本人的声音会被写下来。采集之后、识别之前,由设备上的语音处理单元(VPU)比对声纹;判定为非本人的语音段整段丢弃,不产生任何输入。判定在设备侧完成,音频不出设备。
| 项 | 约定 |
|---|---|
| 判定位置 | 设备侧 VPU 本地比对,不上云,音频不离开设备 |
| 录入 | 说 3 句话建立声纹模板(约十秒);模板只存本地,可一键删除 |
| 闸门行为 | 本人 → 进入识别与整理;非本人 → 整段丢弃,不产生任何文字 |
| 拒识反馈 | 提示「未识别为本人,已忽略」并可立刻重说,避免「说了没反应」 |
| 判定粒度 | 按语音段判定,不是整段一刀切:会议里只写我说的话 |
| 已知限制 | 误拒与误受(感冒、疲劳、距离变化);录音回放不防,需要活体线索;提供重试与临时关闭开关 |
| 隐私 | 声纹模板属生物特征:本地加密存储、可删除,不参与云端处理 |
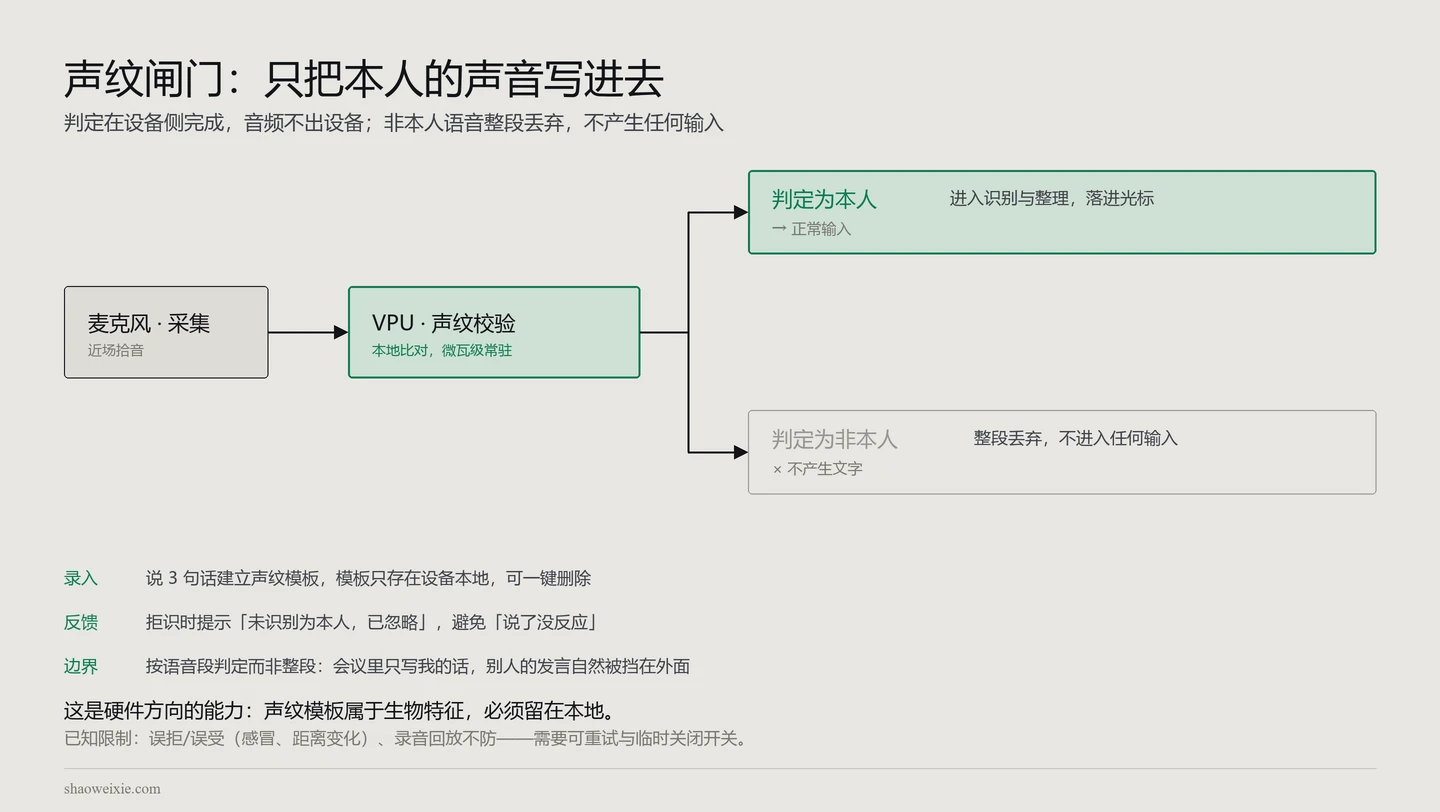
设备负责听清、也只写本人的声音;主机负责成文
当前状态:这一节是硬件方向的能力规划,软件版本还没有声纹链路——需要采集侧硬件(麦克风阵列 + VPU + 物理按键)先落地。
五、隐私与可控
- 密钥不留明文:所有 API Key 存在 Windows 凭据管理器里(按当前账户加密);早期版本留下的明文密钥文件会被自动转存并清空删除。
- 历史只存本机:每条记录写入本地一个 jsonl 文件(场景、音频时长、识别文本、整理结果),托盘菜单里可以一键关闭;“最近记录"点一下即复制。
- 云端失败自动降级:识别与整理任一环节失败都会回落到本地,输入过程不会中断。
- 托盘即控制台:状态与今日统计(次数 / 字数 / 说话分钟)、输出模式、识别与整理引擎、输出语言、润色强度、场景自动切换、历史开关、编辑热词、设置密钥,全部在托盘菜单里完成。
一次使用到底要等多久
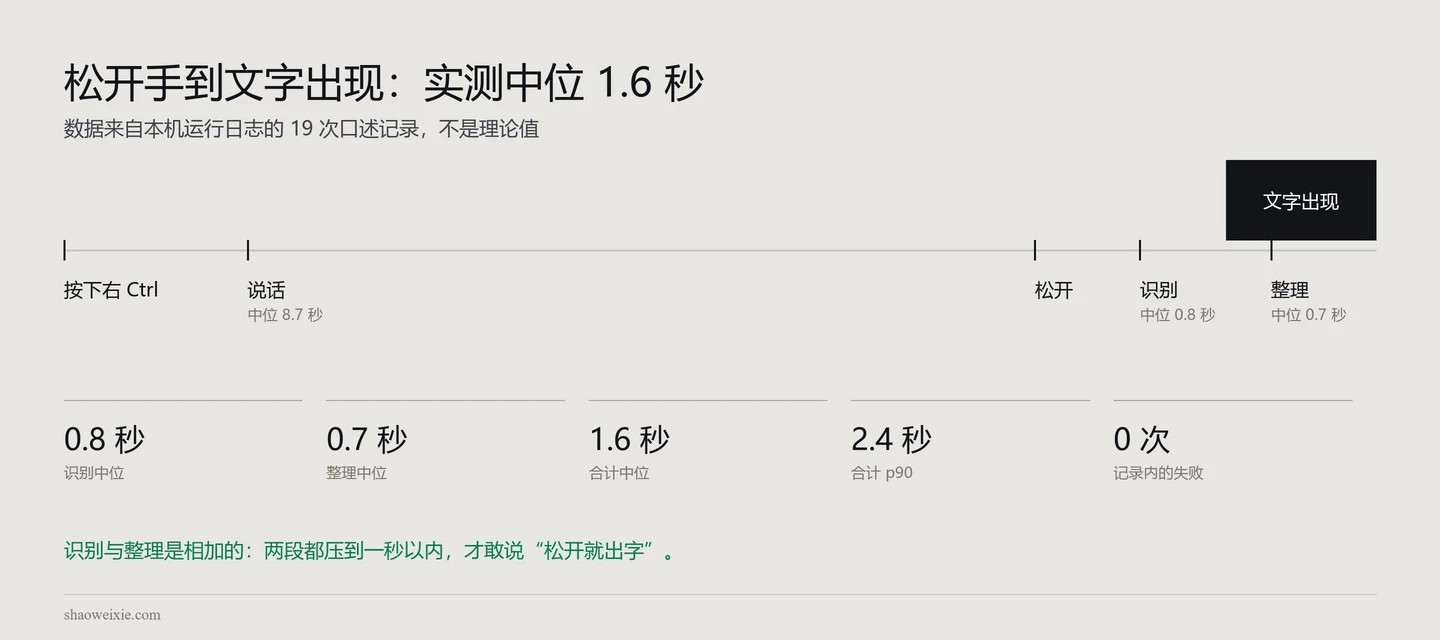
产品页最容易吹的就是速度,所以这里放实测数据。下表来自本机运行日志里的 19 次口述记录(聚合统计,不含任何内容):
| 环节 | 中位 | p90 |
|---|---|---|
| 语音识别 | 0.8 秒 | 1.4 秒 |
| 文本整理 | 0.7 秒 | 1.0 秒 |
| 合计(松开手 → 文字出现) | 1.6 秒 | 2.4 秒 |
这 19 次记录里没有一次失败。识别与整理的时间是相加的,所以两段都压到一秒以内,才敢说"松开就出字”。
屏幕上的每一步也都有反馈:正在听 / 识别中 / 已完成 / 出错,提示条按状态换色(见上图),托盘图标同步变色,余光就能确认。
配套硬件:耳机形态能补上的那一段
三段链路里,采集是软件唯一补不回来的一环——信息在这一步丢了,后面用什么模型都是在猜。而耳机形态刚好落在这一环上:它离嘴最近、腾得开双手、身上还有地方放按键。
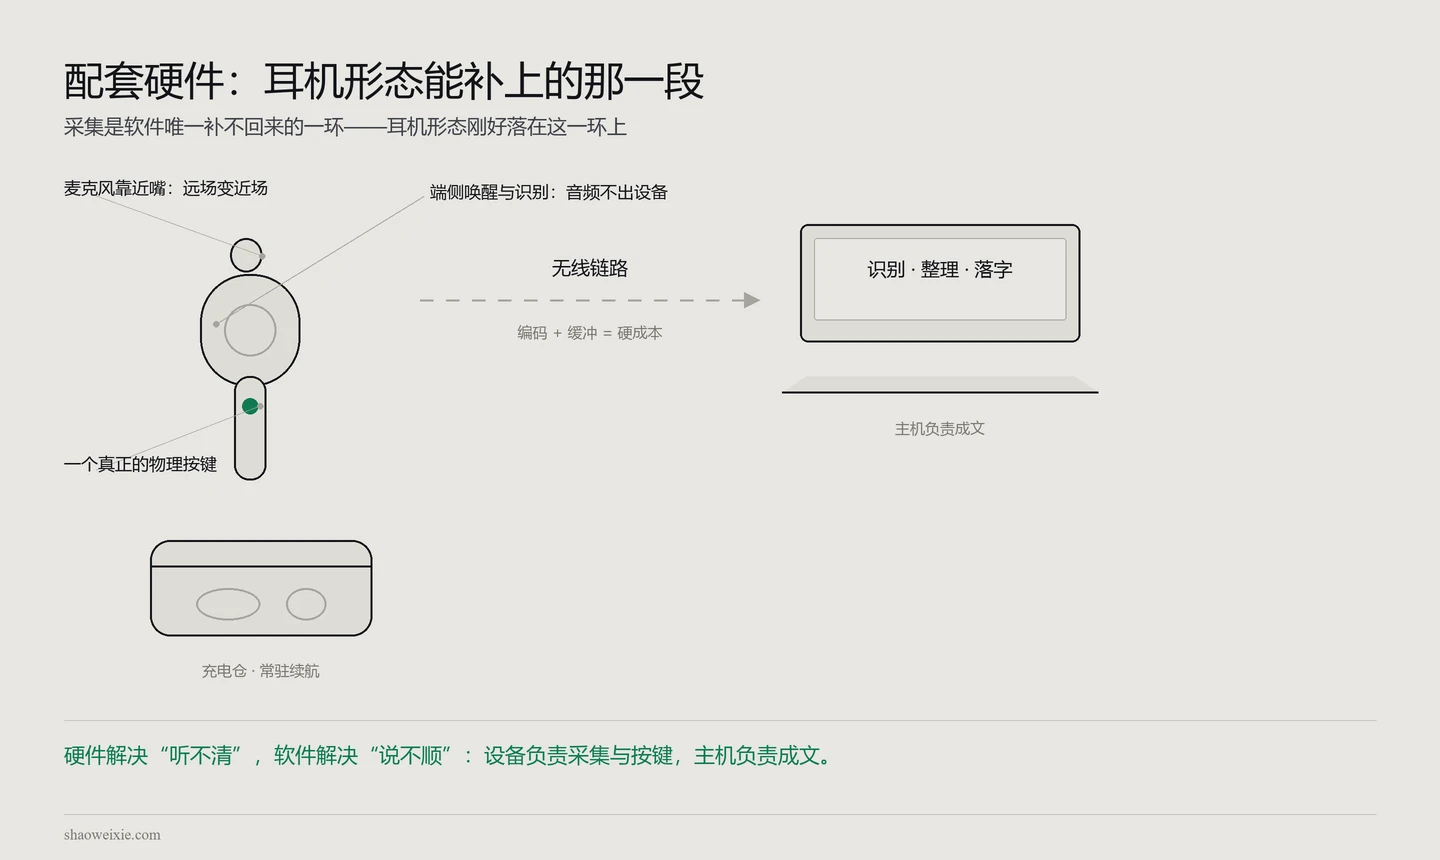
设备负责采集与按键,主机负责成文
| 硬件能补的 | 为什么 |
|---|---|
| 麦克风靠近嘴 | 把远场拾音变成近场拾音,信噪比直接决定识别准确率的上限 |
| 一个真正的物理按键 | 点一下开始、再点一下结束,不用占用键盘,也不用靠屏幕确认"按下去了没有" |
| 端侧唤醒与端侧识别 | 音频不出设备(隐私),不依赖网络往返(延迟) |
| 常驻续航的充电仓 | 让它像耳机一样"一直在身上",而不是每次都要找出来开机 |
| 硬件补不了的 | 为什么 |
|---|---|
| 「整理」这一步 | 需要语言模型与场景上下文(当前是哪个应用、哪个窗口、有没有选中文字),这些信息在主机上最全 |
| 热词表这类确定性问题 | 人名、公司名、型号该怎么写是事实问题,跟算力无关 |
| 串行耗时的大头 | 端到端时延通常是"识别 + 整理 + 网络往返"相加,后者才是大头 |
结论还是那句话:设备负责听清,主机负责成文。两者是分工,不是替代——所以这一步的形态大概率是"耳机 + 主机配合",而不是把整套能力塞进耳机。
状态与下一步
- 已经能用(Python 版):Windows 托盘版,上面的功能都在跑,日常自用中。
- Rust 版已经能跑:核心用 Rust 重写完成——release 单文件 2.14 MB(LTO + strip + abort,不需要安装任何运行时),12 个模块 1234 行;全局按键、音频采集、托盘、粘贴时序、剪贴板、凭据存储全部换成 Rust 生态的库(
windows-sys/cpal/tray-icon/keyring/arboard),并新增开机自启。整理逻辑与提示词 1:1 移植。 - Rust 版的已知差异:本地识别引擎尚未移植,目前走云端实时识别(WebSocket 流式,边说边出字)。要完全离线,本地识别这一块还要接一次。
- 移动端:iOS 与 Android 版本在规划中,会陆续推出;首页对应入口可以先预约。
- 在想:配套硬件的形态。采集与按键这两段能不能交给耳机形态去做,以及用 VPU 声纹闸门把输入限制成本人——上面两节和这篇文章里都做了拆解。
目前是自用版本,没有对外发布。如果你在做类似的东西,或者想聊聊"口语怎么变成书面语"这件事,写信给我就好。